Inteligência de Leilões de Imóveis
Transforma anúncios de leilão espalhados numa base consultável e guarda a história de preço de cada imóvel — inclusive a dos leilões que já terminaram. A leitura da matrícula por modelo está construída e testada, ainda não rodando em escala.
- Papel
- Projeto próprio, sozinho
- Período
- desde fevereiro de 2026
- Estado
- Revisita semanal automática, painéis locais
- Código
- Privado
Números
Medido diretamente no banco em 22/09/2026, com a coleta indo de 17/02/2026 a 18/09/2026 (revisita semanal). Só 32 imóveis seguem ativos: imóvel que sai do leilão continua na base — é justamente esse histórico que o projeto existe para guardar.
O problema
O anúncio de um leilão não diz se o imóvel merece atenção. O que decide isso está na matrícula — ônus, penhoras, consolidação — que vem como PDF digitalizado, e boa parte dos anúncios chega incompleta, sem valor avaliado, sem área ou sem número de matrícula.
E há uma janela que não reabre: quando o leilão termina, o anúncio simplesmente some do site e não volta. Quem não guardou no dia perdeu para sempre — não existe arquivo público de desfechos.
O que faz
- Coleta os anúncios com um Chrome real dirigido por Playwright, atravessando a proteção anti-robô do portal.
- Reconcilia com o arquivo oficial da Caixa, que passou a ser a fonte primária para os imóveis dela.
- Pipeline que lê a matrícula em PDF e a transforma em análise de risco estruturada — ônus, sinalizações, consolidação — conferindo a área contra o anúncio. O pipeline está pronto e ainda não rodou em escala com modelo real: o OCR ainda está em fase de bake-off.
- Acompanha o ciclo de vida de cada leilão (ativo, fora da listagem, saiu) e guarda a série histórica de preço.
- Serve tudo por uma API que é também o agendador, com painéis de frescor, qualidade, cobertura e movimento de preço.
- Mapa por município e busca conversacional sobre os trechos de matrícula, com banco vetorial.
Como foi construído
Arquitetura Medallion em Python: bronze imutável em disco, silver validado por schema com Pydantic e persistido com SQLAlchemy, gold a construir — com três pipelines (coleta, extração de matrícula e re-visita) instrumentados pela mesma telemetria.
A extração da matrícula é feita em duas etapas separadas de propósito — primeiro transcrever o documento com fidelidade, só depois estruturar o texto em JSON de risco — com os prompts no git e um harness de regressão pronto, que grava o hash de cada prompt; o gabarito real de documentos ainda não foi montado. Para o OCR, um bake-off de três modelos locais contra 28 referências, medido por CER/WER, ainda como experimento.
Guardar o original bruto antes de entender qualquer coisa
Todo download é gravado em disco com hash sha256, tamanho e timestamp antes de qualquer interpretação. Regravar o mesmo conteúdo não faz nada; conteúdo diferente no mesmo caminho não sobrescreve — levanta erro de integridade e vira uma versão nova. Cada linha da camada tratada aponta de qual arquivo bruto veio, e com qual hash.
A razão está escrita no próprio projeto: reprocessar é barato, recoletar o passado é impossível. Um bug de parser nunca destrói histórico — conserta-se o código e reprocessa-se o bruto. O preço é cerca de 2,4 GB de armazenamento duplicado, a impossibilidade de "limpar" dado feio no lugar, e uma escrita extra em cada passo. O complemento é a quarentena: registro que não passa na validação vai para um canto com o motivo anotado, não entra sujo, não é descartado em silêncio, e como não conta como coletado, é tentado de novo na próxima execução.
Stack
Coleta
Dados
IA e busca
Serviço
Telas
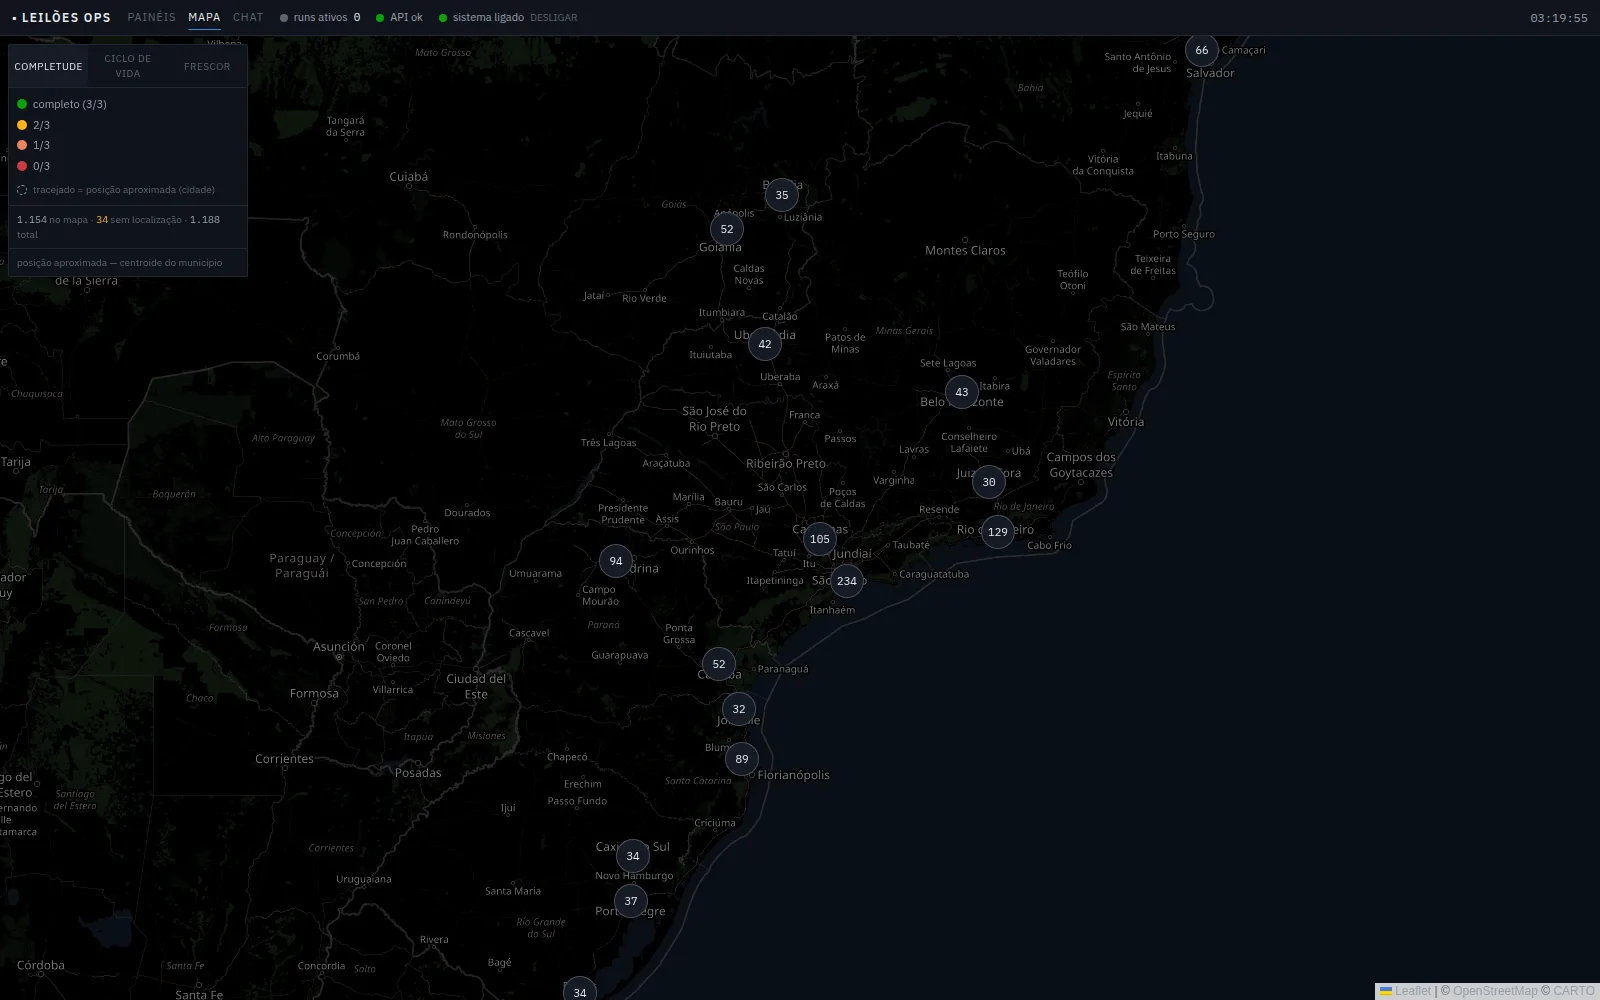
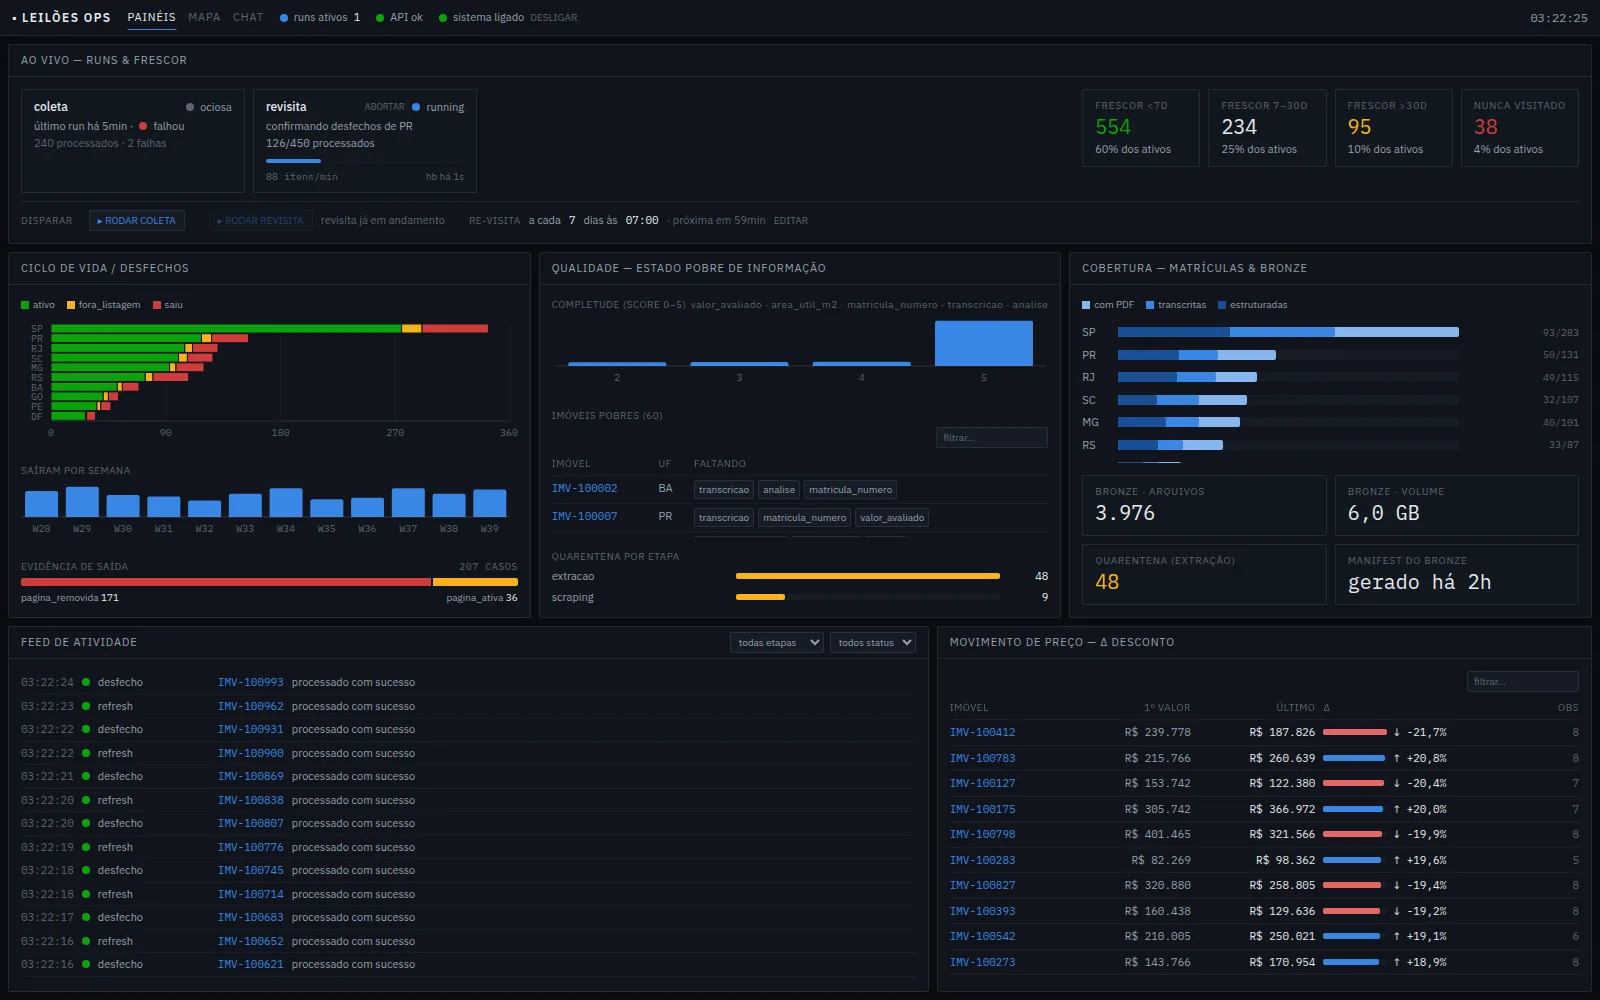
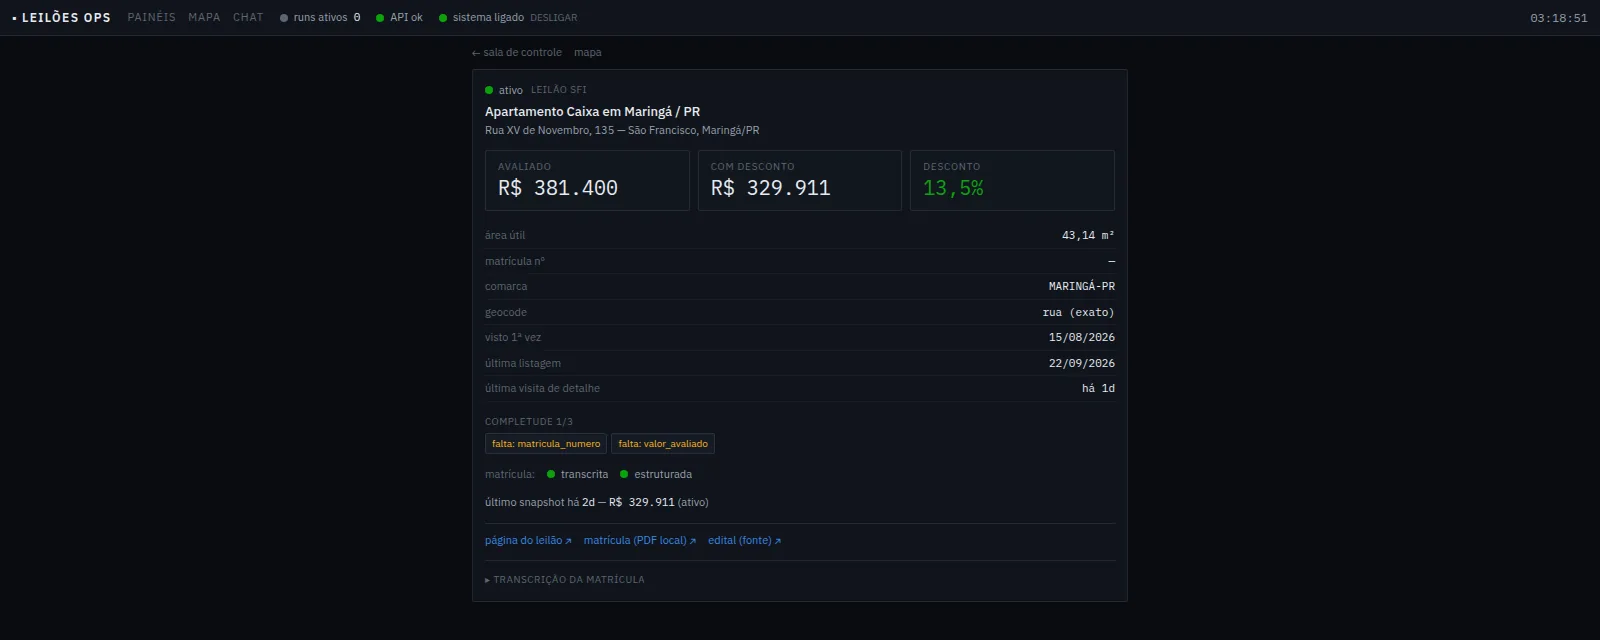
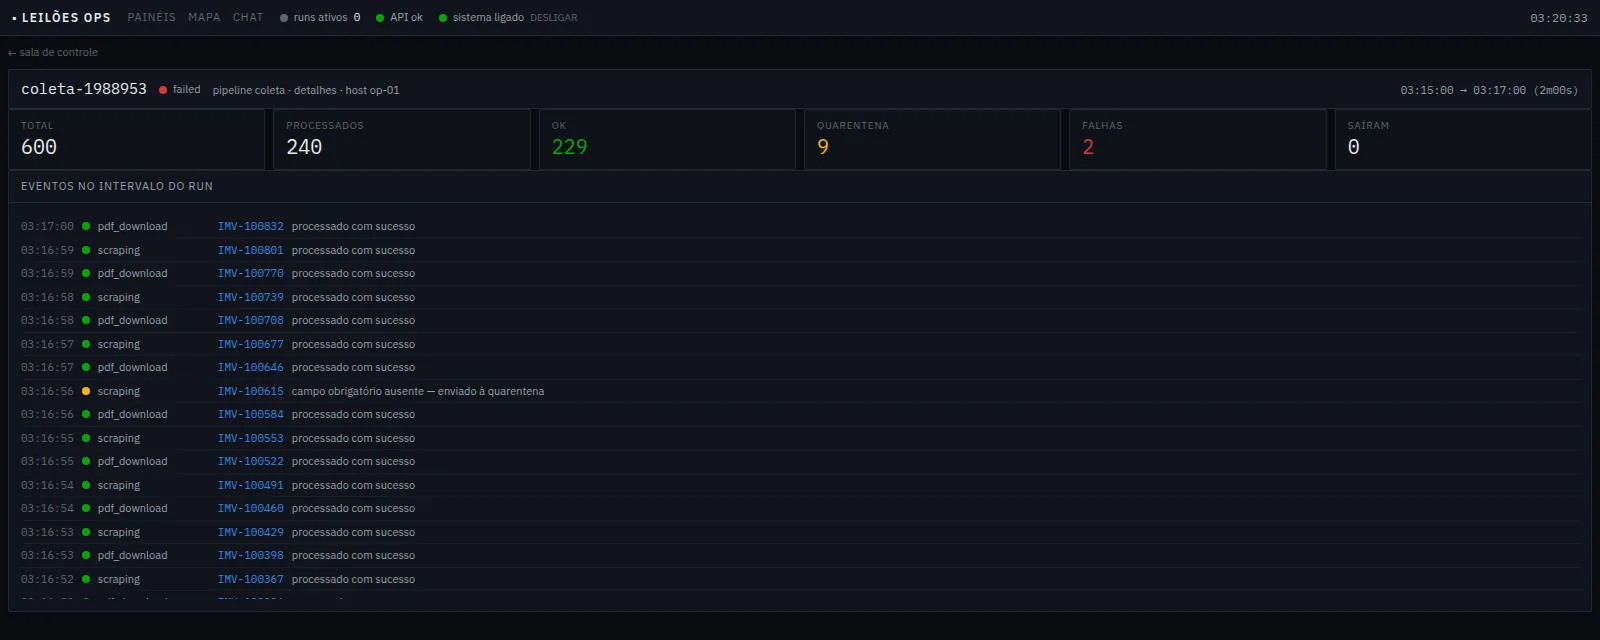
Capturas do painel rodando contra a API simulada do próprio repositório: cerca de 1.200 imóveis sintéticos com id IMV-1000xx, sem nome de pessoa, CPF ou telefone. No mapa, o fundo foi trocado por tiles do OpenStreetMap só para a captura.