Robô de atendimento no WhatsApp
Um assistente que responde no WhatsApp pela API oficial da Meta e lembra da conversa: cada mensagem chega num webhook FastAPI, o histórico sai do Supabase com o horário de cada fala, e o LLM responde sabendo o que foi dito antes, inclusive em outro dia.
- Papel
- Projeto próprio, sozinho
- Em uso
- 2 clientes
- Desenvolvimento
- dezembro de 2025 a janeiro de 2026
- Código
- Privado
O problema
Na API oficial do WhatsApp Business, cada mensagem chega sozinha: um POST no webhook com o número de quem escreveu e o texto. Não existe "conversa" do lado da Meta. Um assistente que responde só à última frase esquece o nome do cliente, o pedido de ontem e o que ele acabou de combinar.
A outra metade do problema era de engenharia: WhatsApp, banco e provedor de LLM são três serviços externos, e testar a regra da conversa não podia depender de nenhum deles estar de pé.
O que faz
- Recebe as mensagens no webhook oficial da Meta, incluindo o handshake de verificação do endpoint (hub.challenge).
- Reconhece o número: cliente novo é cadastrado na primeira mensagem; cliente conhecido continua de onde parou.
- Guarda cada fala, do cliente e do robô, no Supabase, com data e hora.
- Monta o prompt com o histórico e o horário de cada mensagem, para o modelo entender "ontem", "agora há pouco" e "sábado".
- Responde pela API de envio do WhatsApp e, se o LLM falhar, devolve uma mensagem de desculpas em vez de deixar o cliente sem resposta.
Como foi construído
Python com FastAPI no webhook, Supabase (PostgreSQL) com duas tabelas — clientes e mensagens —, OpenAI gpt-4o-mini para a resposta e httpx assíncrono para a Graph API da Meta. O núcleo, MessageProcessor, faz o ciclo inteiro: identifica o cliente, grava a mensagem, carrega o histórico, pede a resposta, grava a resposta e envia.
O núcleo não sabe que existe WhatsApp
Arquitetura hexagonal com portas em typing.Protocol: o MessageProcessor depende só de três contratos — repositório de conversa, serviço de LLM e envio de mensagem. Supabase, OpenAI e WhatsApp são adaptadores nas bordas, montados no webhook e injetados no núcleo. Trocar o provedor de LLM ou o banco é escrever um adaptador novo, sem tocar na regra.
O ganho aparece no teste: o caminho feliz de um cliente novo — mensagem recebida, cliente criado, resposta do LLM e envio — roda num teste com as três portas simuladas, sem rede e sem chave de API. O preço aceito foi simplicidade na montagem — os adaptadores são criados a cada requisição, sem contêiner de injeção — adequada ao porte do projeto.
Stack
Aplicação
Dados
Integrações
Testes
Telas
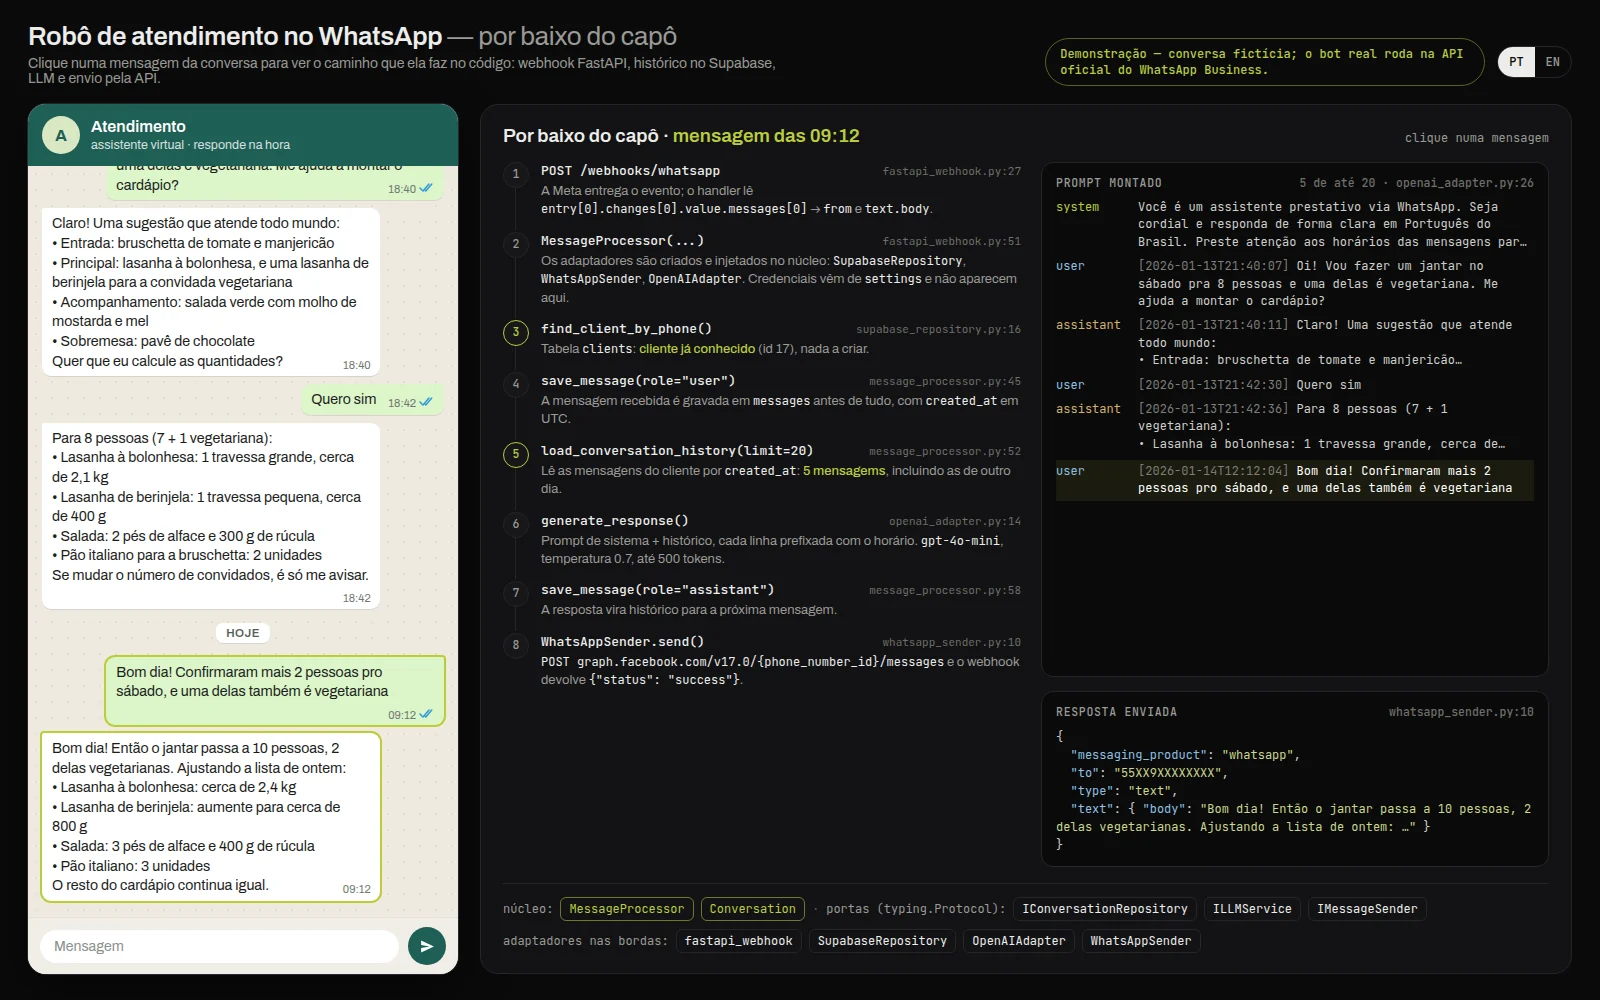
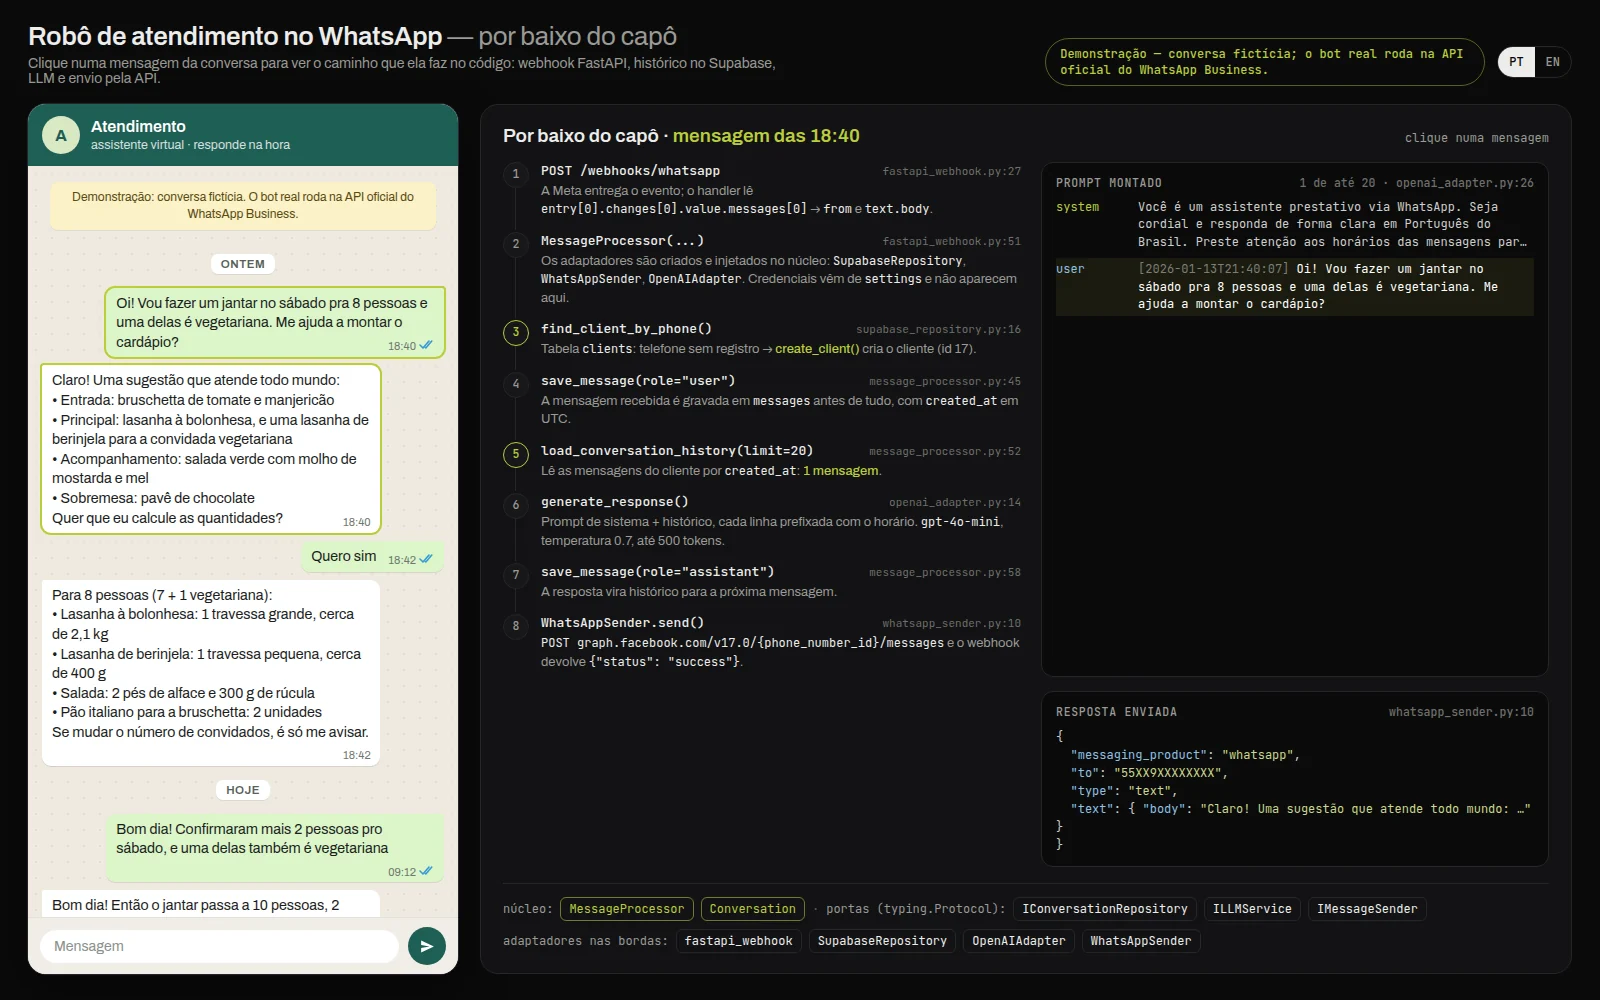
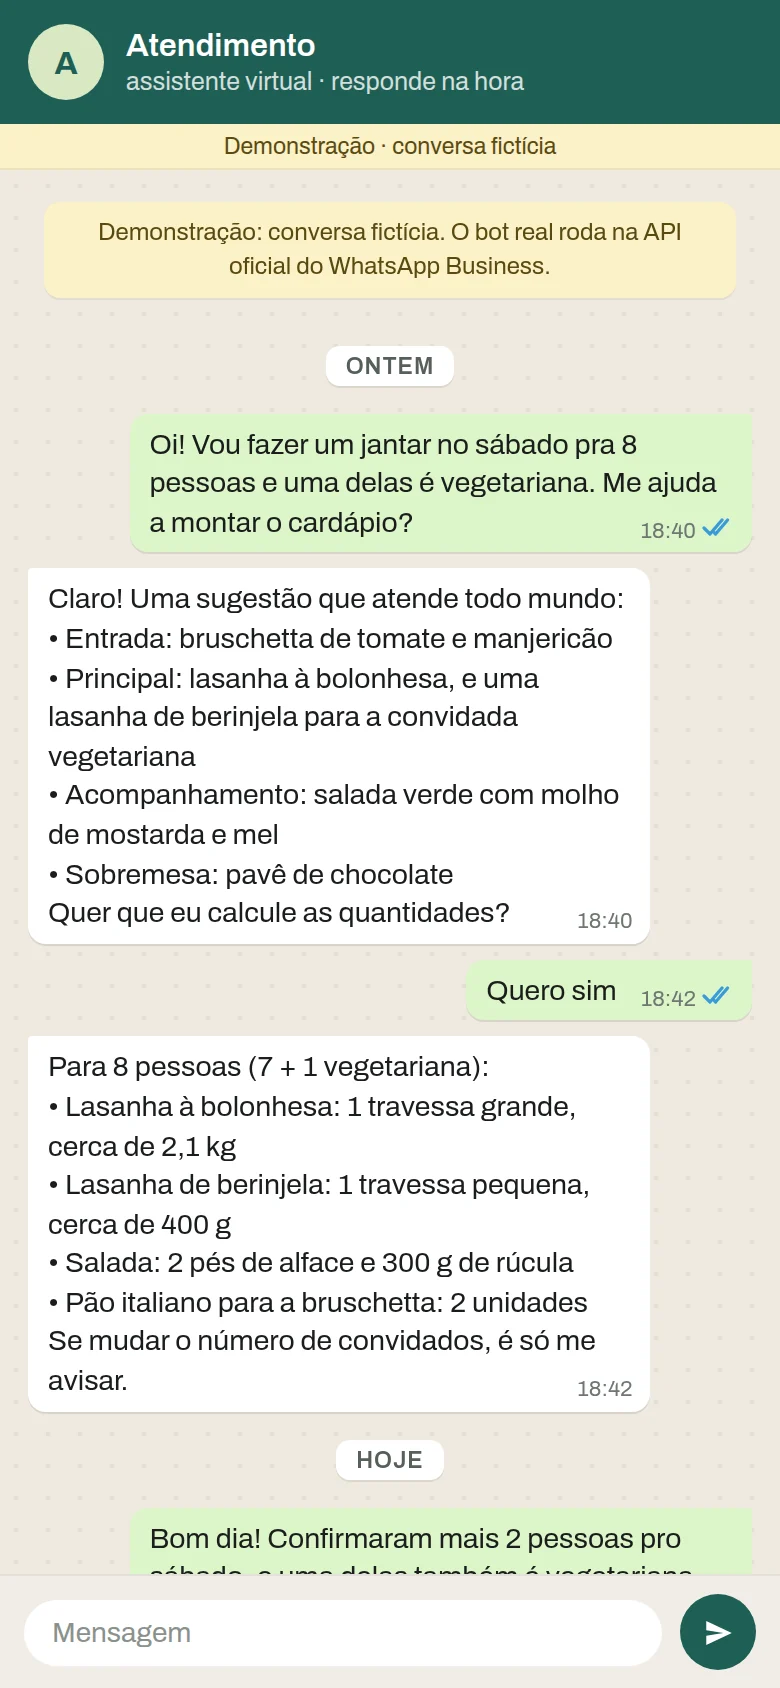
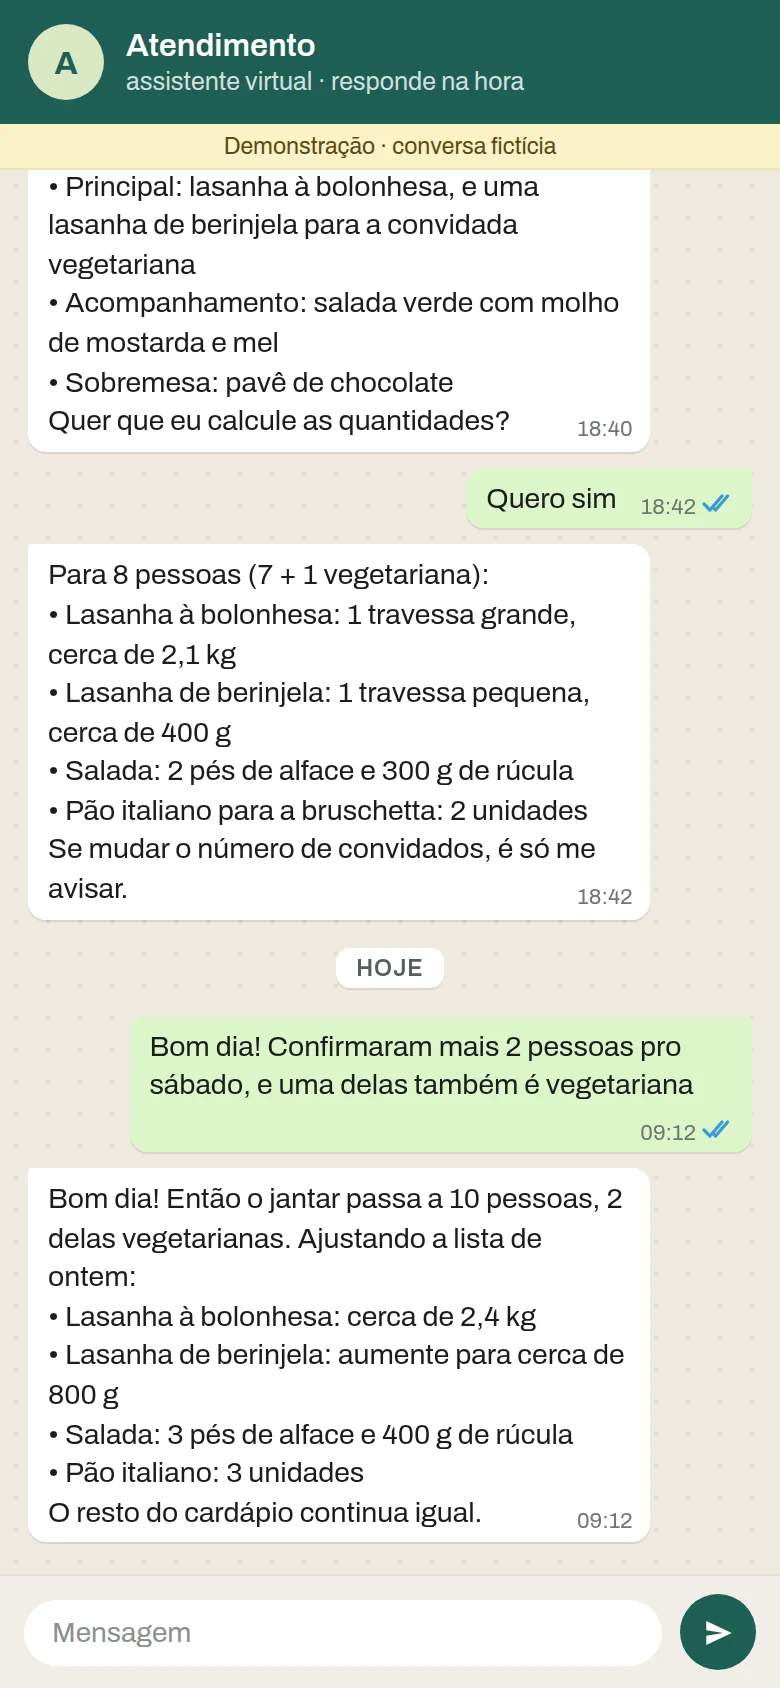
As telas são de uma demonstração estática feita para esta página: a conversa é fictícia (cliente, número e horários inventados) e as respostas foram escritas à mão, não geradas pelo modelo. O painel "por baixo do capô" é fiel ao código — nomes de módulos, métodos, tabelas, prompt de sistema e chamada à API, com arquivo e linha. O bot real roda na API oficial do WhatsApp Business; o código é privado.